
ИИ не пишет тысячу статей по одной кнопке — это миф, который приводит к свалке низкокачественного контента и потере позиций. Работает иначе: контентная платформа собирает конвейер из модулей, где ИИ-агент парсит нишу, анализирует выдачу, предлагает структуру и черновик, а человек проверяет факты и доводит текст до публикации. Дальше материал уходит в CMS через API, роботы получают пинг, карта сайта обновляется, позиции отслеживаются, а старые статьи переписываются по данным аналитики. Разберем эту архитектуру по шагам: где стоят точки контроля качества, как контент доходит до индексации и как посчитать окупаемость.
- Контентная платформа — это не волшебная кнопка, а конвейер из модулей с точками контроля: парсинг ниши → анализ выдачи → семантика → структура → драфт → фактчекинг → SEO-оптимизация → публикация → мониторинг → обновление по данным
- ИИ-агент генерирует галлюцинации в фактах, поэтому фактчекинг встраивают отдельным модулем между драфтом и публикацией; двойной барьер (машинная сверка + экспертный контроль) отсекает ошибки до индексации и защищает позиции от фильтров E-E-A-T
- После публикации платформа автоматически отправляет URL через IndexNow и Google Indexing API, обновляет sitemap с актуальными датами и отслеживает позиции; статьи с просадками после апдейтов переписываются по данным аналитики вместо ручного мониторинга
- ROI считают за 4–6 месяцев по формуле (доход от органики − затраты на платформу и редактуру) / затраты; один редактор может обслуживать десятки статей в месяц вместо 5 в неделю вручную благодаря автоматизации рутины
Что такое контентная платформа и как устроен ИИ-конвейер
Контентная платформа — это набор связанных модулей, где каждый выполняет свою задачу: сбор ниши, анализ выдачи, генерация структуры, драфт, фактчекинг, SEO-правки, автопубликация, мониторинг позиций и обновление старых статей. ИИ-агент берет на себя рутину — парсит запросы, смотрит топ-10 конкурентов, собирает LSI-слова и предлагает черновик. Человек или чек-лист стоит на точках контроля: проверяет факты, тон, добавляет экспертизу. Такой конвейер выдает предсказуемый результат, потому что ошибка на одном модуле не рушит весь процесс, а ловится на следующем шаге.
Как менялись инструменты для создания цифровых текстов
Сначала тексты писали в редакторе вручную, потом добавились сервисы проверки уникальности и подбора ключей — Text.ru, Key Collector, сборщики семантики. Копирайтер собирал ТЗ, сам анализировал конкурентов и вписывал ключи. На одну статью в 8000 знаков уходил рабочий день, а масштабирование упиралось в количество исполнителей.
Переход от ручного копирайтинга к нейросетям кардинально изменил экономику редакции: теперь масштабирование зависит не от количества авторов, а от вычислительных мощностей и грамотной архитектуры промптов.
Генеративные модели сместили нагрузку: ИИ выдает драфт за минуты, но без контроля плодит фактические ошибки и штампы. Поэтому инструменты объединили в платформы с API-связкой — семантика, генерация, публикация и трекинг работают в одном окне. Человек перешел от написания к редактуре и постановке задач, а объем вырос с 5 статей в неделю до десятков.
Платформа — это не волшебная кнопка, а слаженная архитектура процессов
Запуск в полном автопилоте ломается на индексации. Поисковики не гарантируют попадание в индекс без карты сайта, внутренней перелинковки и регулярных обновлений. Апдейты Google и Яндекса меняют требования — статья, ранжировавшаяся месяц назад, проседает, если ее не править под новые сигналы. Без мониторинга позиций проблему замечают, когда трафик уже упал.
Рабочая архитектура держится на обратной связи. Логи показывают, какие URL робот обошел, аналитика — какие страницы дают отказы, трекер позиций — где статья застряла на второй странице. Эти данные возвращаются в конвейер: агент помечает материал на доработку, редактор допиливает, платформа переотправляет страницу на переобход. Цикл замыкается, а не обрывается на публикации.
Роль умных агентов в непрерывном маркетинговом цикле
ИИ-агент — это не одна модель, а связка ролей. Один модуль собирает частотность запросов и группирует их в кластеры, второй разбирает структуру топ-10 и находит пробелы в темах конкурентов, третий генерирует план и черновик, четвертый прогоняет текст по SEO-чек-листу: плотность ключей, заголовки, мета-теги, alt у картинок.
После публикации агент не останавливается. Он раз в цикл сверяет позиции статьи с целевыми, ловит просадки после апдейтов и ставит задачи на обновление: добавить свежие данные, переписать устаревший абзац, усилить внутренние ссылки. A/B-тесты заголовков и мета-описаний показывают, какой вариант дает больше кликов из выдачи. Так контент не стареет разом, а поддерживается точечными правками по данным.
🌊 Корпоративный блог пишет себя сам
Organic Flow — SaaS-платформа, которая возьмет контент-маркетинг на себя. Наш агент изучает нишу, пишет экспертные SEO-тексты с картинками и публикует по 1 статье каждый день.
Пошаговая архитектура: от сбора поисковых запросов до готового драфта
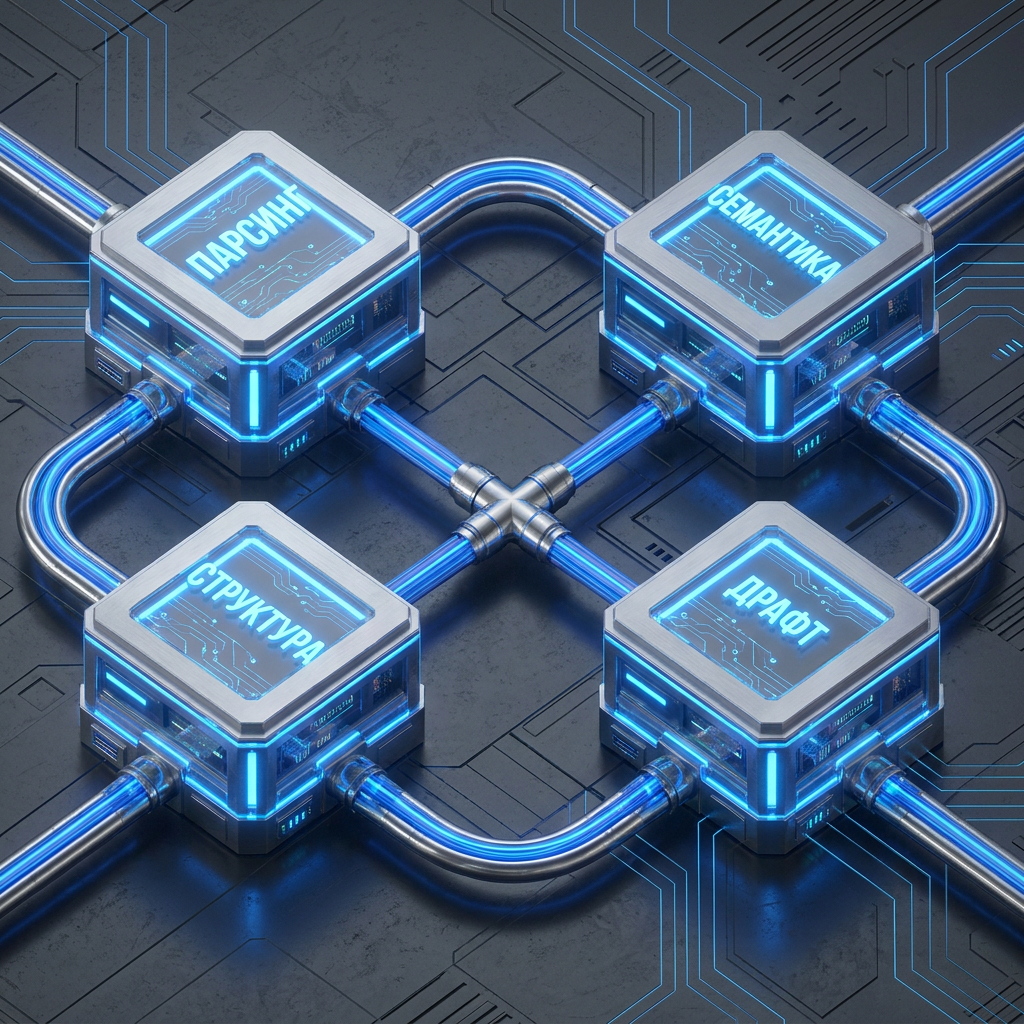
Первые четыре модуля конвейера превращают сырую нишу в готовый черновик. Порядок жесткий: парсинг ниши → анализ выдачи → семантическое ядро → структура → драфт. Каждый шаг отдает данные следующему, поэтому ошибка в кластеризации ломает и структуру, и текст. ИИ-агент здесь не пишет наугад, а опирается на реальные запросы пользователей, страницы из топ-10 и разметку конкурентов. Человек включается в контрольных точках, но основную рутину — сбор частотностей, группировку, черновой каркас — берет на себя автоматика. Разберем каждый из четырех модулей и данные, которые он обрабатывает.
Автоматический парсинг ниши и глубокий анализ выдачи
Агент стартует с API Wordstat, Google Keyword Planner и сервисов вроде Ahrefs или Keys.so. Он выгружает запросы по маске, снимает частотности и подтягивает подсказки из автодополнения поиска. Параллельно парсит выдачу по каждому запросу: URL топ-10, заголовки, объем текста, наличие таблиц, видео и FAQ-блоков. Эти данные показывают, какой формат Google и Яндекс уже считают релевантным по теме.
Анализ выдачи отвечает на вопрос: стоит ли вообще заходить в запрос. Если топ забит агрегаторами и маркетплейсами, статья не пробьется — агент помечает такой кластер как бесперспективный. Он оценивает средний объем текста конкурентов, тип интента (информационный, коммерческий, навигационный) и разброс доменов. На выходе — таблица запросов с частотностью, сложностью и форматом контента, которая уходит в модуль семантики.
📋 Чек-лист: Оценка перспективности поискового кластера
- Анализ конкурентов в ТОП-10: проверка выдачи на наличие крупных маркетплейсов и недосягаемых агрегаторов.
- Определение типа интента: точная классификация запроса на информационный, коммерческий или навигационный.
- Оценка объема контента: подсчет среднего количества символов и структуры у текущих лидеров выдачи.
- Проверка форматов: выявление скрытых потребностей аудитории (необходимость сводных таблиц, видеороликов или блоков FAQ).
Генерация семантического ядра и точная кластеризация тем
Собранные запросы агент группирует по смыслу и по общности выдачи. Метод кластеризации по топу надежнее ручной группировки: если у двух запросов совпадает 3–5 URL в топ-10, поисковик считает их одной темой — значит, они идут в одну статью. Так система избегает каннибализации, когда две страницы конкурируют за один запрос и обе проседают в позициях.
Каждый кластер получает главный запрос, LSI-фразы и список сущностей, которые обязаны быть в тексте. Например, для кластера про индексацию агент вытащит слова «карта сайта», «robots.txt», «краулинговый бюджет». Эти сущности повышают полноту раскрытия темы — тот самый фактор, по которому алгоритмы оценивают экспертность. Готовое ядро с кластерами и списком LSI передается в модуль структуры.
Строим экспертную структуру статьи на основе данных конкурентов
Агент разбирает заголовки H2 и H3 из статей топ-10 и составляет карту подтем. Если восемь конкурентов из десяти раскрывают блок «стоимость» или «сравнение форматов», система добавляет его в структуру — этот блок ждет и поисковик, и читатель. Пропуск популярной подтемы снижает полноту и роняет шансы на топ. К заимствованному каркасу агент добавляет подтемы из LSI-ядра, которых у конкурентов нет, — так текст закрывает больше интентов.
На выходе — план с заголовками, тезисами под каждый блок и указанием формата: где нужна таблица, где нумерованный список, где FAQ для расширенного сниппета. Здесь стоит первая контрольная точка человека: редактор проверяет логику плана и убирает лишние блоки до генерации драфта. Согласованная структура уходит в модуль написания черновика, о котором речь пойдет дальше.
Интеграция фактчекинга и защита бренда от мусорного контента
Фактчекинг встраивают в конвейер отдельным модулем между драфтом и SEO-правками, а не оставляют на финальную вычитку. ИИ-агент генерирует правдоподобный текст, но не отличает проверенный факт от выдумки: он подставляет цифры, даты, названия законов и цитаты, которых нет в источниках. Один такой абзац с ложной статистикой или несуществующим товаром бьет по доверию к бренду и роняет позиции под фильтры E-E-A-T. Задача этапа — поймать ошибку до публикации через сверку с источниками, чек-листы и ручной контроль. Ниже разберем, откуда берутся ошибки, какие точки контроля ставить и как доработка сохраняет трафик.
Почему искусственный интеллект ошибается в фактах
Языковая модель предсказывает следующее слово по вероятности, а не сверяет утверждение с базой данных. Когда в обучающих текстах не хватает данных, модель заполняет пробел похожим по форме ответом — так рождаются галлюцинации: выдуманные исследования, кривые проценты, приписанные не тем авторам цитаты. Для читателя это выглядит уверенно и грамотно, поэтому ошибку легко пропустить.
Автономный режим усиливает риск. Агент, который сам собирает выдачу и сам пишет, тянет ошибки из недостоверных сайтов и накапливает их от статьи к статье. Без внешней сверки с первоисточниками модель не знает, что закон изменился, цена выросла, а сервис закрылся. Поэтому факты нельзя доверять генерации целиком — их проверяют отдельным шагом.
Изолированная генерация неизбежно приводит к накоплению критических ошибок. По опыту компании OrganicFlow, без интеграции внешних баз данных и ручной модерации модель начинает выдумывать факты, что мгновенно пессимизирует сайт в поисковой выдаче.
Внедрение обязательных точек контроля и строгих чек-листов
Точку контроля ставят так, чтобы драфт физически не уходил в публикацию без прохождения проверки. Простой рабочий набор: сверка каждой цифры и даты с первоисточником, проверка названий компаний и продуктов на актуальность, поиск цитат в оригинале, отметка спорных утверждений маркером для ручного разбора. Чек-лист оформляют как обязательное поле в CMS — статья со статусом «не проверено» блокируется от автопостинга.
Часть контроля автоматизируют: агент прикладывает к каждому факту ссылку на источник, а второй ИИ-проход ищет противоречия и неподтвержденные заявления. Но финальное решение по спорным местам оставляют человеку или редактору с доступом к нише. Такой двойной барьер — сначала машинная сверка, затем экспертный взгляд — отсекает большинство галлюцинаций до индексации.
Как экспертная доработка спасает позиции сайта в поиске
Поисковики оценивают опыт и экспертность автора. Чистый ИИ-текст без доработки читается ровно и безлико: в нем нет личных примеров, кейсов и деталей, которых нет в открытой выдаче. Редактор добавляет то, что модель не знает — цифры из своей практики, разбор ошибок клиентов, ссылки на свежие данные. Это отличает страницу от сотен таких же сгенерированных копий и удерживает ее в топе.
Доработка влияет и на поведенческие факторы. Когда текст решает задачу читателя, он дочитывает страницу и не возвращается в выдачу — поисковик читает это как сигнал качества. Плюс эксперт правит тон под бренд, убирает штампы и лишние обобщения. Итог: статья проходит апдейты алгоритмов без просадки, потому что за ней стоит проверенный человеком смысл, а не только машинная генерация.
| Критерий оценки качества | Чистая генерация (ИИ-агент) | ИИ + Экспертный фактчекинг |
|---|---|---|
| Фактология и цифры | Высокий риск галлюцинаций, опора на устаревшие базы | Сверка с первоисточниками, 100% достоверность данных |
| Уникальность опыта (E-E-A-T) | Отсутствует (компиляция общеизвестных фактов из ТОПа) | Присутствуют личные кейсы, инсайты и узкая практика |
| Tone of Voice | Шаблонный, машинный, с обилием канцеляризмов | Адаптирован под бренд, живой, убедительный и ритмичный |
| Поведенческие факторы | Высокий показатель отказов из-за обилия «воды» | Глубокое дочитывание благодаря реальному решению боли |
Автоматическая SEO-оптимизация и техническая подготовка текста
SEO-модуль работает после фактчекинга: он не переписывает смысл, а готовит текст под требования поисковиков. Агент проверяет длину и вложенность заголовков, распределяет ключи по тексту, собирает мета-теги, расставляет ссылки и добавляет разметку Schema. Каждый шаг опирается на данные анализа выдачи — частотность запросов, средний объем статей в топе, набор LSI-слов у конкурентов. Результат — файл, который загружается в CMS без ручного форматирования. Ниже разберем три блока этого этапа: работу с ключами, техническую обвязку и доставку материала на сайт.
Органичное вплетение ключевых фраз и работа с LSI-окружением
Агент берет кластер запросов из этапа сбора ниши и распределяет их по тексту с учетом плотности. Прямое вхождение главного ключа ставится в заголовок H1, первый абзац и одну из подсекций, остальные фразы — в разбавленной форме. Переспам отлавливается автоматически: если частота ключа выше медианы по топ-10, модуль помечает абзац для правки. Так текст остается читаемым, а не превращается в перечисление запросов.
LSI-окружение собирается из выдачи и подсказок поиска — это слова, которые встречаются у конкурентов в топе рядом с темой. Для статьи о доставке контента это термины вроде «вебхук», «черновик», «слаг», «редиректы». Агент предлагает список, а редактор отмечает лишнее. Плотность смысла растет за счет терминов по делу, а не за счет синонимов ради объема.
Мета-теги, внутренняя перелинковка и микроразметка
Title и Description агент генерирует под длину сниппета: до 60 символов для заголовка и до 155 для описания, с вхождением ключа ближе к началу. Модуль проверяет, чтобы Title не дублировал H1 дословно и содержал цифру или уточнение — так растет кликабельность в выдаче. Если description обрезается на середине предложения, система пересобирает его.
Перелинковку агент строит по базе уже опубликованных статей: находит смысловые пересечения и предлагает 3–5 ссылок с осмысленными анкорами вместо «читайте тут». Микроразметка добавляется по типу контента — Article, FAQPage, HowTo или BreadcrumbList. Разметка отдается в формате JSON-LD, который вставляется в код без правки шаблона темы. Валидность проверяется через тест структурированных данных до публикации.
Доставка готового материала в CMS через API
Готовый файл уходит на сайт через REST API движка: WordPress принимает материал по маршруту wp/v2/posts, Ghost и Strapi — по своим эндпоинтам с токеном авторизации. Агент передает заголовок, тело, мета-поля, категории, теги и слаг одним запросом. Картинки загружаются в медиабиблиотеку отдельным вызовом, после чего их ID подставляются в текст. Публикация ставится в статус «черновик» или «запланировано» — финальное решение остается за редактором.
После загрузки система дергает вебхук: генерирует sitemap заново и отправляет пинг в Google через Indexing API или обновленную карту сайта. Каждая операция пишется в лог — если API вернул ошибку 401 или 429, задача повторяется по расписанию, а не теряется молча. Такой обмен занимает секунды и снимает ручную работу по копированию текста в редактор движка.
Автоматизация доставки контента через API устраняет человеческий фактор при верстке. Статья мгновенно получает нужные теги, а поисковые роботы призываются на страницу в ту же секунду.
Индексация в поиске, пинг роботов и ускорение доставки контента
Написать статью — половина дела. Пока страницу не увидел робот Google или Яндекса, трафика не будет. Скорость индексации зависит от трех вещей: как быстро краулер узнает об URL, насколько техничен код страницы и как часто поисковик доверяет сайту обновления. Платформа автоматизирует первый пункт: после публикации она отправляет пинг, добавляет URL в карту сайта и передает его через IndexNow и Google Indexing API. Разница ощутима — новый материал попадает в индекс за часы, а не за недели. Ниже разберем механику: как роботы находят публикации, как обновляются карты сайта и как отслеживать судьбу каждой страницы после индексации.
Как поисковые роботы оперативно обнаруживают новые публикации
Робот доходит до новой страницы двумя путями: сам обходит сайт по внутренним ссылкам либо получает прямой сигнал. Первый вариант медленный — краулер возвращается на сайт по своему расписанию, и для нового блога это интервал в дни. Второй быстрее: протокол IndexNow разом уведомляет Bing, Яндекс и партнеров одним запросом при публикации URL, а Google Indexing API принимает адреса напрямую от сайта.
Платформа встраивает эти вызовы в момент публикации. Как только статья прошла фактчекинг и ушла в CMS, скрипт отправляет URL в очередь на индексацию и логирует ответ поисковика. Дополнительно помогает перелинковка: новый материал сразу получает ссылки из свежих и старых статей, чтобы робот при следующем обходе нашел его по нескольким маршрутам, а не по одному.
Автоматическое обновление карт сайта и отправка логов
Карта сайта — это список URL с датами последнего изменения, по которому робот планирует обход. Если карта статична, поисковик не понимает, что статья обновилась, и приоритет обхода падает. Платформа генерирует sitemap.xml динамически: при каждой публикации или правке в файл добавляется URL с актуальным тегом lastmod, а сам файл пингуется в Search Console и Яндекс.Вебмастер. Для крупных проектов карту дробят на индексный файл и сегменты по разделам, чтобы уложиться в лимит 50 000 URL.
Логи закрывают слепую зону: серверные записи показывают, заходил ли робот на конкретный URL, какой код ответа получил и сколько страниц обошел за визит. Платформа собирает эти данные и выявляет проблемы — краулер тратит бюджет обхода на служебные страницы, упирается в редиректы или получает 5xx. Анализ логов вместе с картой сайта дает точную картину: что робот видит, а что игнорирует.
Мониторинг позиций и технический аудит проиндексированных страниц
После индексации начинается отслеживание позиций. Платформа снимает данные по ключевым запросам ежедневно или раз в несколько дней, фиксирует динамику по каждому URL и сопоставляет ее с апдейтами поисковиков. Если статья вошла в топ-20, но не растет выше, это сигнал доработать текст: расширить недостающие подтемы, усилить перелинковку, обновить факты. Просадка после апдейта показывает, какие страницы попали под фильтр качества и требуют переписи в первую очередь.
Технический аудит проверяет здоровье уже проиндексированных страниц. Платформа сканирует их на битые ссылки, дубли title и description, отсутствие canonical, медленную загрузку и ошибки разметки Schema. Часть проблем чинится автоматически, часть уходит в отчет человеку. Такой контур замыкает конвейер: данные о позициях и технике возвращаются в модуль обновления, и статьи переписываются не наугад, а по конкретным сигналам из аналитики.
Техническое здоровье страницы после индексации не менее важно, чем качество самого текста. Даже идеальная статья потеряет трафик, если сервер начнет отдавать ошибки или сломается микроразметка.
Аналитика результатов, A/B-тесты и непрерывный цикл обновлений
Публикация статьи — не финиш, а точка старта для аналитики. После индексации платформа собирает данные из Search Console и Метрики: позиции по запросам, CTR сниппетов, время на странице, глубину скролла, отказы. Эти цифры показывают, какие материалы приносят трафик, а какие висят на второй-третьей странице выдачи без кликов. A/B-тесты заголовков, title и первых абзацев показывают, что реально влияет на поведение читателя. На основе метрик система формирует очередь на доработку и переписывание. Разберем, как из этих данных собрать замкнутый цикл: аналитика → гипотеза → правка → повторный замер результата.
Контент-платформа как инструмент постоянной аналитики поискового трафика
Платформа подтягивает данные через API Search Console и Яндекс.Вебмастера: показы, клики, средняя позиция и CTR по каждому URL и запросу. Эти показатели выгружаются на дашборд, где статьи сортируются по потенциалу. Материал с 500 показами и позицией 11–15 — кандидат на доработку: он близок к первой странице, но не добирает кликов. Материал с высокими показами и низким CTR требует правки сниппета, а не тела текста.
К поисковым данным платформа добавляет поведенческие метрики из систем веб-аналитики: время на странице, процент дочитываний, карту кликов. Связка двух источников отделяет проблему выдачи от проблемы контента. Если пользователь заходит, но уходит через 10 секунд — виноват текст, а не сниппет. Такой разбор превращает набор цифр в конкретный список задач для ИИ-агента и редактора.
Регулярный пересмотр и актуализация старых статей по данным метрик
Статьи стареют: цены меняются, сервисы закрываются, поисковики выкатывают апдейты и переоценивают выдачу. Платформа помечает материалы, у которых за квартал просели позиции или упал CTR, и ставит их в очередь на пересмотр. ИИ-агент повторно парсит топ-10 по целевому запросу, сравнивает структуру статьи с текущими лидерами и предлагает, какие блоки добавить, а какие устарели. Человек проверяет факты и утверждает правки.
Жизненный цикл статьи не заканчивается кнопкой «Опубликовать». Динамическое обновление фактуры и структуры на основе свежей аналитики — это единственный способ удерживать топ в условиях постоянных апдейтов поисковиков.
Обновление работает лучше написания нового текста: у страницы уже есть история индексации и ссылочный вес. После правки платформа отправляет URL на переобход, фиксирует дату изменения в карте сайта и через 2–4 недели замеряет эффект. Если позиции выросли — гипотеза верна, если нет — материал возвращается в очередь с новой гипотезой. Так контент поддерживается в актуальном состоянии без ручного мониторинга каждой статьи.
Как измерить реальную окупаемость инвестиций в автоматизированный маркетинг
Окупаемость считают не по количеству опубликованных статей, а по деньгам. Базовая формула: ROI = (доход от органического трафика − затраты на платформу и редактуру) / затраты × 100%. В доход входят продажи, заявки и подписки, пришедшие из поиска, — их отслеживают через цели в аналитике и UTM-метки. В затраты — подписка на CMS и API, оплата токенов ИИ, часы редактора на фактчекинг и доработку.
Считать ROI имеет смысл на горизонте 4–6 месяцев: органика набирает позиции постепенно, и первые статьи начинают приносить трафик через 2–3 месяца после индексации. Полезно разделять метрики по когортам: сколько принесла статья за первый месяц и сколько — за полгода с учетом обновлений. Такой расчет показывает, окупает ли себя конвейер и какие темы дают лучшую отдачу на вложенный час редактора.